FileMaker zu SQL migrieren: Strategie und Fallstricke für die IT
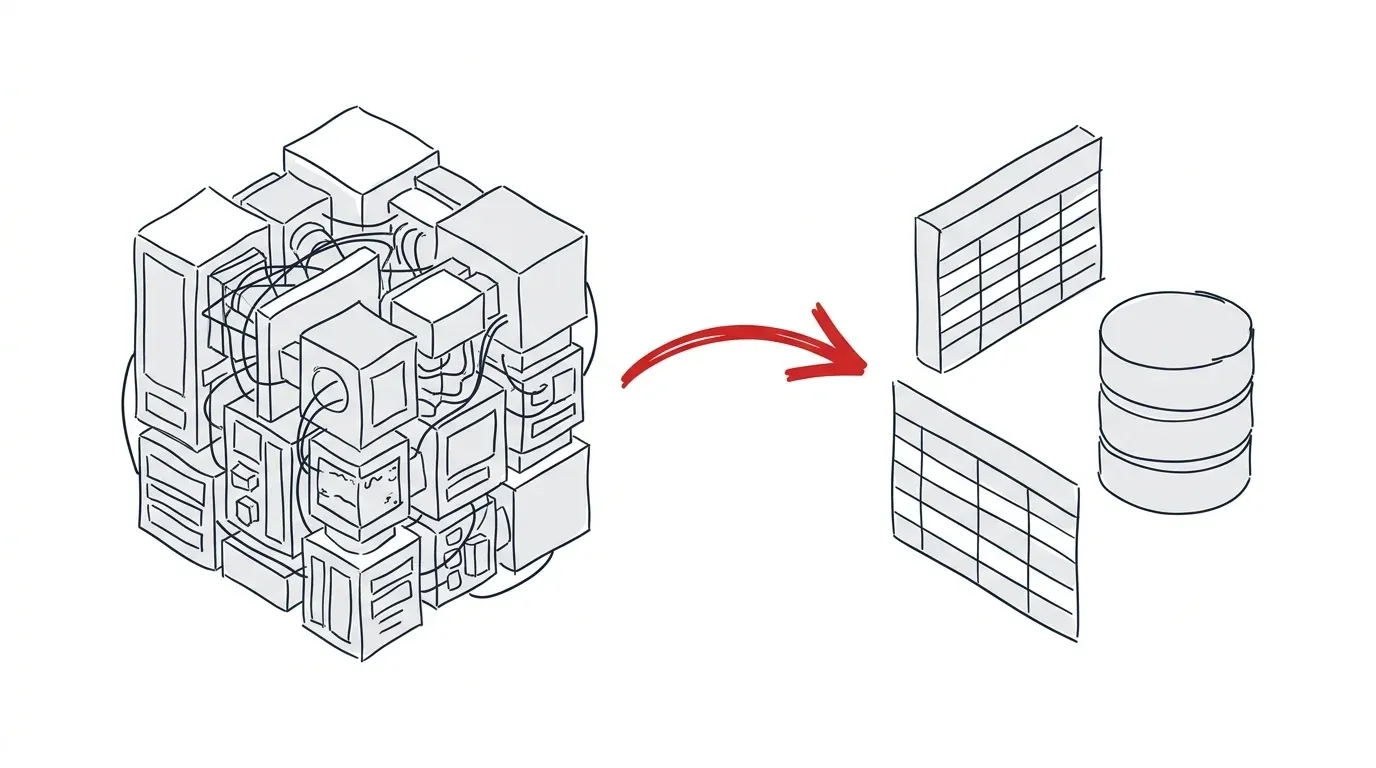
Viele mittelständische Unternehmen haben über Jahre hinweg umfangreiche Datenbanklösungen aufgebaut, die nun an technische und prozessuale Grenzen stoßen. Wenn IT-Verantwortliche planen, FileMaker zu SQL zu migrieren, geht es meist darum, die Performance bei wachsenden Datenmengen zu sichern und eine zukunftsfähige IT-Architektur zu etablieren. Eine solche Umstellung ist jedoch kein Vorhaben, das sich durch einen einfachen Software-Assistenten bewältigen lässt. Während die reinen Nutzdaten oft relativ unkompliziert exportiert werden können, stellen die eng verwobenen Strukturen aus Datenspeicherung, Benutzeroberfläche und Geschäftslogik die eigentliche Hürde dar. Dieser Leitfaden beleuchtet die technischen Voraussetzungen und zeigt, worauf Sie bei der Überführung der Datenstrukturen achten müssen.
Warum historische Datenbanken im Alltag ausbremsen
Systeme, die ursprünglich für kleine Teams konzipiert wurden, entwickeln sich über die Jahre oft zu geschäftskritischen, stark angepassten Anwendungen. Doch mit steigenden Anforderungen zeigen sich architektonische Schwächen. Ein wesentlicher Kritikpunkt ist, dass es sich um arbeitsgruppenorientierte Systeme handelt, die im Unternehmensnetzwerk erhebliche Probleme verursachen können, da sie keine klassische Client-Server-Architektur aufweisen. Zudem fehlt ein professionelles Transaktionsmanagement, und Logdateien werden nicht im selben Maße wie bei relationalen Großsystemen geführt.
Oft wird gehofft, dass Versions-Updates die Leistungsprobleme beheben. In der Praxis kann jedoch das Gegenteil eintreten. Es zeigt sich, dass neuere Versionen durch die Integration zusätzlicher Features oftmals langsamer arbeiten als ihre Vorgänger. Wenn die Hardware nicht parallel deutlich aufgerüstet wird – aktuelle Server-Software setzt teilweise zwingend neuere Betriebssysteme wie Windows Server 2019 voraus –, kann die Performance nach einem Update spürbar sinken. Bei Unternehmen mit sehr großen Datenbeständen führt dies im Arbeitsalltag zu unerwünschten Verzögerungen.
Die monolithische Struktur als Hindernis bei der Übernahme
Die größte technische Hürde liegt in der Konstruktion der alten Anwendungen. Felder, Ansichten, Skripte und die reinen Daten werden in einer einzigen Datei gespeichert, anstatt eine sinnvolle Trennung von Backend und Frontend vorzunehmen. Zudem wird in diesen Lösungen in der Regel kein echter Quellcode kompiliert, stattdessen kommen vorrangig Makros zur Steuerung der Prozesse zum Einsatz.
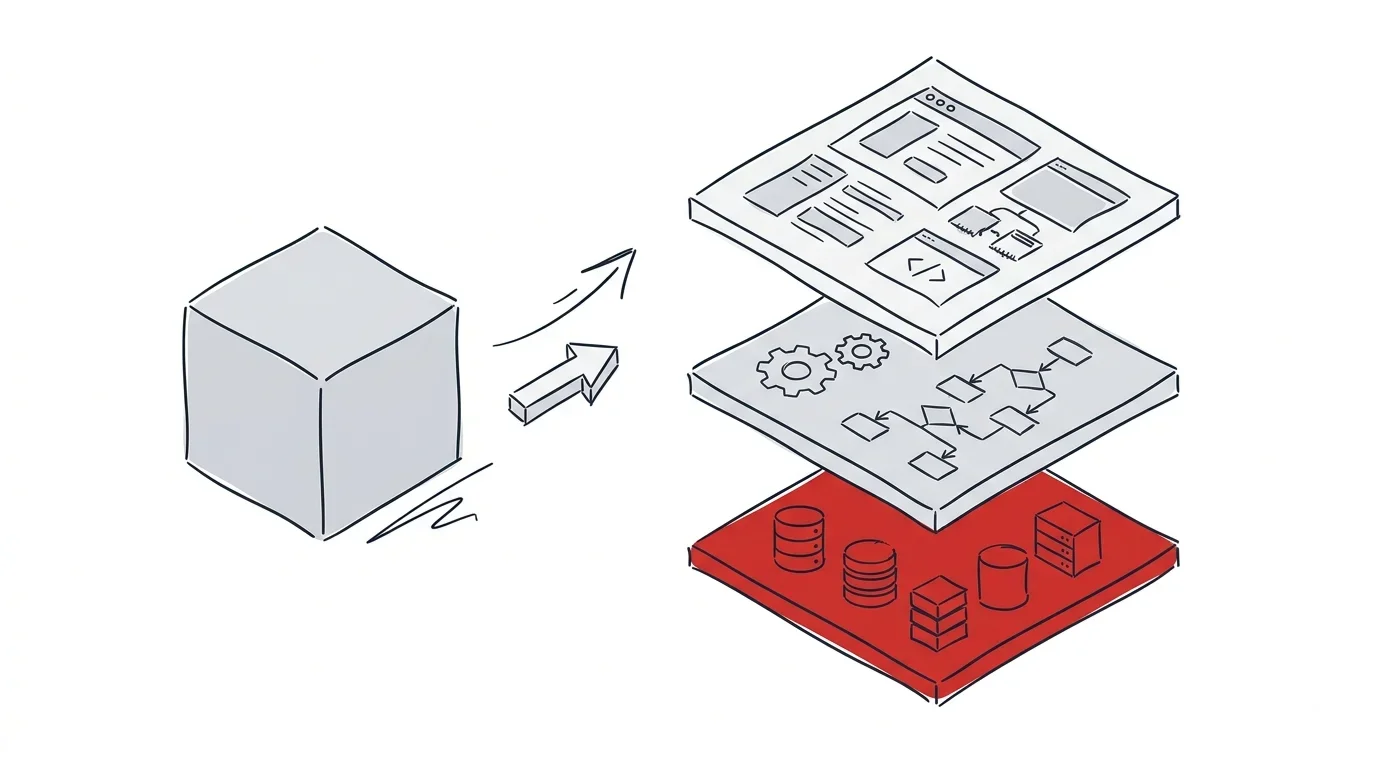
Wer eine FileMaker-Datenbank-Migration anstrebt, muss diese enge Verzahnung gedanklich und technisch auflösen. Ein reiner Export greift zu kurz, da das relationale SQL-System in Zukunft lediglich als Backend zur strukturierten Datenspeicherung fungiert. Dass die Benutzeroberfläche und die bisherigen Makros in der neuen Systemumgebung komplett neu aufgebaut werden müssen, ist eine unumstößliche Tatsache, die frühzeitig in der Projektplanung berücksichtigt werden muss.
Daten und Strukturen systemisch auslesen
Die reinen Informationen aus dem Altsystem herauszubekommen, ist in der Praxis oft der unkomplizierteste Schritt. Viel kritischer für den IT-Leiter ist es, die exakten Felddefinitionen und Tabellenstrukturen zu extrahieren, um sie präzise in das neue relationale Schema zu mappen.
Über SQL-Abfragen gegen bestimmte Systemtabellen lässt sich die innere Struktur der alten Lösung abholen. Konkret können Administratoren Abfragen an die internen Tabellen FILEMAKER_TABLES und FILEMAKER_FIELDS richten. Die Tabelle für die Felder liefert dabei essenzielle Metadaten für das anstehende Mapping. Dazu gehören der Tabellenname, der Feldname, die Feld-ID sowie die Feldklasse, die anzeigt, ob es sich um ein normales Eingabefeld, ein berechnetes Formelfeld oder ein Statistikfeld handelt. Besonders hilfreich: Aus dieser Systemtabelle lässt sich direkt der SQL-Datentyp des jeweiligen Feldes auslesen, was die Konzeption der neuen Datenbank massiv erleichtert.
Wege und Formate für den Datenexport
Sobald die Tabellenstruktur in der neuen SQL-Umgebung definiert ist, müssen die historischen Datensätze physisch transferiert werden. Das alte System bietet hierfür standardmäßig verschiedene Exportformate an, darunter PDF, Excel und CSV.
Für den maschinellen Austausch mit SQL-Datenbanken eignen sich CSV-Dateien (Comma-Separated Values) in der Regel am besten, da sie die Informationen in einem simplen, textbasierten Format vorhalten, das von praktisch allen Import-Tools gelesen werden kann. Vor dem eigentlichen Export können IT-Verantwortliche die Datensätze filtern und die exakte Reihenfolge der Felder festlegen, um sie an das Zielschema anzupassen.
Soll ein FileMaker-MySQL-Export realisiert werden, bildet ein sauber konfigurierter CSV-Export meist die stabilste Brücke. Dieser Exportprozess lässt sich über Skripte automatisieren. In diesen Export-Skripten lassen sich Kriterien hinterlegen, sodass die Daten vor dem Export sortiert oder gefiltert werden und nur wirklich relevante Datensätze den Weg in das neue System finden.
Internes Tooling und Feldzuordnungen verstehen
Auch wenn es bei der Umstellung auf SQL um einen vollständigen Systemwechsel geht, hilft es, die interne Logik der bisherigen Software zu verstehen. Für interne Updates gibt es ein spezielles Data Migration Tool, das eine Entwickler-Lizenz erfordert. Dieses Konsolen-Werkzeug migriert Daten in leere Datenbank-Klone.
Spannend für IT-Leiter ist dabei die Logik, nach der das Tool arbeitet: Beim Transfer versucht das System, Felder zunächst über den Namen und anschließend über die interne ID zuzuordnen. Werden Felder in der alten Datenbank umbenannt und neue Felder mit dem alten Namen angelegt, fließen die Daten in die neuen Felder. Accounts, Datensätze, Indexe und interne Record-IDs werden übertragen, während Layouts, Berechtigungen und neue Tabellenstrukturen ignoriert werden. Dieses Wissen über die Bindung an interne IDs und Feldnamen schärft das Bewusstsein dafür, wie fehleranfällig ein manueller Export sein kann, wenn Tabellen im Vorfeld unsauber umbenannt wurden.
Die anspruchsvolle Suche nach dem passenden Frontend
Da die neue SQL-Datenbank fortan ausschließlich für die Haltung der relationalen Daten zuständig ist, fehlt den Anwendern schlagartig die gewohnte Arbeitsumgebung. Die Frage, welche Technologie zukünftig für das Frontend eingesetzt wird, entscheidet maßgeblich über die Akzeptanz im Unternehmen.
Hier stehen Unternehmen vor einer weitreichenden Entscheidung. Standard-Software deckt branchenübliche Prozesse oft gut ab. Wurden im alten System jedoch hochgradig individuelle Freigabe-Workflows oder spezifische Logiken abgebildet, reicht der Standard meist nicht aus. Die Entwicklung von Individualsoftware ist dann ein möglicher Weg, um die exakten Geschäftsprozesse abzubilden. Um das finanzielle Risiko und die Budgetbelastung zu Beginn gering zu halten, bietet sich oftmals die Entwicklung eines Minimum Viable Product (MVP) an. So können die Kernfunktionen des neuen Frontends früh im Arbeitsalltag getestet werden, bevor komplexe Randfunktionen aus der alten Makro-Welt nachprogrammiert werden.
Nächste Schritte für eine stabile Systemarchitektur
Die Ablösung einer historisch gewachsenen monolithischen Struktur erfordert ein systematisches, gut geplantes Vorgehen. Eine fundierte Analyse der bestehenden Tabellenstrukturen und Feldklassen bildet das zwingende Fundament, um das SQL-Backend performant zu dimensionieren. Da Oberflächen und verknüpfte Skripte technisch bedingt nicht automatisiert in eine neue Programmiersprache übersetzt werden können, bietet das Projekt zugleich die Chance, veraltete Arbeitsabläufe kritisch zu hinterfragen. Ein sauber aufbereiteter und gefilterter CSV-Export sichert dabei den fehlerfreien Übergang der wertvollen Unternehmensdaten in die neue Ära der IT-Infrastruktur.
Häufige Fragen zur Umstellung der Datenbankarchitektur
Lassen sich alte Skripte und Makros direkt in SQL konvertieren?
Nein. SQL ist eine reine Abfragesprache für strukturierte Datenbestände. Die bisherige Geschäftslogik, die Benutzeroberfläche und sämtliche Skripte müssen in einer separaten Frontend- oder Middleware-Lösung von Grund auf neu entwickelt oder in einer neuen Standardsoftware konfiguriert werden.
Wie kann ich die bestehende Tabellenstruktur auslesen?
Die Struktur lässt sich durch SQL-Abfragen gegen die internen Systemtabellen FILEMAKER_TABLES und FILEMAKER_FIELDS ermitteln. Diese Abfragen liefern detaillierte Metadaten zu Feldnamen, Datentypen und Tabellenbeziehungen.
Welches Dateiformat eignet sich am besten für den Datenexport?
Für die Überführung in relationale SQL-Systeme (wie MySQL, PostgreSQL oder MS SQL) hat sich das CSV-Format bewährt. Es ist textbasiert, systemunabhängig und kann durch Export-Skripte vorab bereinigt und gefiltert werden.
Warum wird die alte Datenbank bei großen Datenmengen so langsam?
Das System wurde ursprünglich für kleinere Arbeitsgruppen konzipiert und besitzt keine echte Client-Server-Architektur. Zudem werden Daten, Layouts und Skripte in einer einzigen monolithischen Datei verarbeitet, was bei hohen Nutzerzahlen und großem Datenvolumen zu starken Netzwerk- und Performanceproblemen führt.
Was passiert beim Export mit internen Berechtigungen und Layouts?
Beim Export in fremde Systeme wie SQL werden ausschließlich die reinen Rohdaten übertragen. Spezifische Layout-Einstellungen, Nutzergruppen oder Berechtigungskonzepte verbleiben im Altsystem und müssen im neuen Frontend vollständig neu aufgesetzt werden.