RAG-Architektur: Bausteine für eigene KI-Wissenssysteme
Ein Prototyp für Retrieval-Augmented Generation ist schnell gebaut: Dokumente in eine Vektordatenbank laden, ein Sprachmodell anbinden, fertig. Im produktiven Betrieb zeigt sich dann, dass die Qualität der Antworten an vielen einzelnen Entscheidungen hängt. Wie werden Dokumente zerlegt? Welches Embedding-Modell versteht deutsche Fachbegriffe? Wie sieht ein Mitarbeiter nur die Dokumente, die er sehen darf? Dieser Ratgeber beschreibt die RAG-Architektur Baustein für Baustein und zeigt, welche Optionen es jeweils gibt.
Was RAG grundsätzlich ist und wofür es sich im Wissensmanagement eignet, erklärt unser Ratgeber Was ist RAG-KI?. Hier geht es um die technische Umsetzung.
RAG und reines LLM im Vergleich
Ein reines Sprachmodell antwortet aus dem Wissen, das in seinen Parametern gespeichert ist. Ein RAG-System sucht vor jeder Antwort passende Textstellen in angebundenen Quellen und gibt sie dem Modell als Kontext mit.
| Kriterium | Reines LLM | RAG-System |
|---|---|---|
| Wissensbasis | Trainingsdaten bis zum Trainingsende | angebundene Dokumente und Datenbanken |
| Aktualität | veraltet mit dem Trainingsstand | so aktuell wie der Index |
| Quellenangaben | keine belastbaren Belege | Verweis auf gefundene Textstellen möglich |
| Zugriffsrechte | nicht steuerbar | Filterung je Nutzer bei der Suche |
| Interne Daten | nur durch Fine-Tuning | ohne erneutes Training nutzbar |
Die Bausteine einer RAG-Architektur
Eine produktive RAG-Architektur besteht aus zwei Strecken. Die Indexierung bereitet Dokumente auf und legt sie durchsuchbar ab. Die Abfrage nimmt eine Frage entgegen, sucht passende Textstellen, prüft die Rechte und erzeugt die Antwort. Beide Strecken bestehen aus Bausteinen, die Sie einzeln auswählen und austauschen können.
Dokumente aufbereiten und in Chunks zerlegen
Sprachmodelle und Embedding-Modelle verarbeiten nur begrenzt lange Texte. Dokumente werden daher in Abschnitte zerlegt, sogenannte Chunks. Die einfachste Methode schneidet nach einer festen Länge mit etwas Überlappung. Besser funktioniert es meist, entlang der Dokumentstruktur zu schneiden, also nach Überschriften, Absätzen oder Tabellen. Zu kleine Chunks verlieren den Zusammenhang, zu große verwässern die Suche. Speichern Sie zu jedem Chunk Metadaten wie Quelldokument, Abschnittstitel, Datum und Berechtigungen. Diese Metadaten brauchen Sie später für Filter, Quellenangaben und Zugriffsrechte.
Embedding-Modell wählen
Das Embedding-Modell übersetzt Text in Vektoren, deren Abstand die inhaltliche Ähnlichkeit abbildet. Für deutsche Unternehmensdokumente sollte das Modell mehrsprachig trainiert sein und Fachbegriffe Ihrer Branche gut abbilden. Offene Modelle wie BGE-M3 oder multilingual-e5 lassen sich auf eigener Hardware betreiben, sodass Dokumente für die Indexierung nicht an einen externen Dienst gehen und Sie einen teuren Vendor Lock-in vermeiden. Wichtig: Fragen und Dokumente müssen mit demselben Modell eingebettet werden. Ein späterer Modellwechsel bedeutet, den gesamten Bestand neu zu indexieren.
Vektordatenbank auswählen
Die Vektoren und Metadaten liegen in einer Vektordatenbank. Für viele Unternehmen reicht pgvector, eine Erweiterung für PostgreSQL. Sie hat den Vorteil, dass Vektoren neben den übrigen Geschäftsdaten in einer bekannten Datenbank liegen und vorhandene Backup- und Rechtekonzepte weiter gelten. Für größere Bestände oder anspruchsvolle Filter gibt es spezialisierte Systeme wie Qdrant, das als Open Source auf eigenen Servern läuft. Beide Varianten lassen sich im eigenen Rechenzentrum oder bei einem Hoster in Deutschland betreiben, etwa in Docker-Containern. So bleiben Dokumentinhalte und Vektoren in Ihrer Kontrolle.
Hybride Suche und Reranking
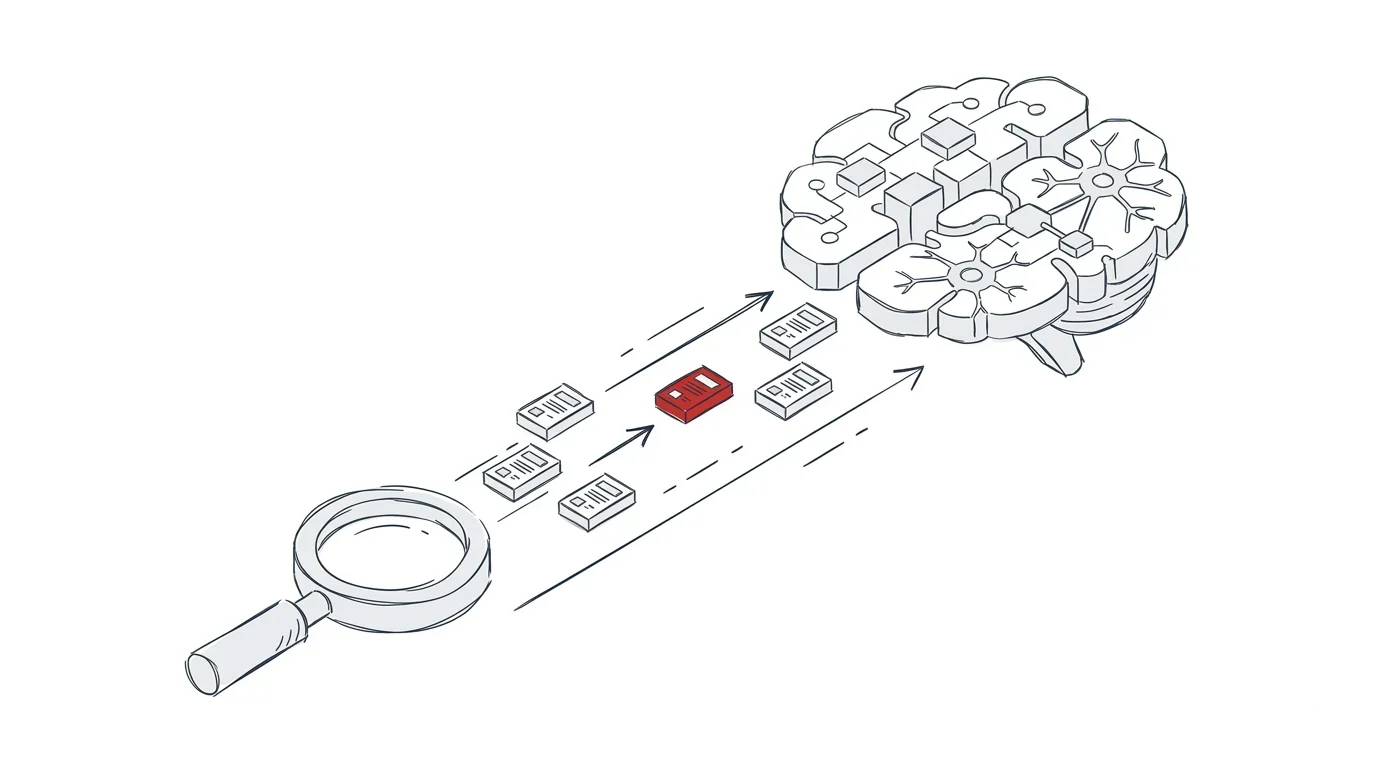
Die reine Vektorsuche findet inhaltlich ähnliche Texte, übersieht aber oft exakte Begriffe wie Artikelnummern, Paragrafen oder Produktnamen. Eine hybride Suche kombiniert deshalb die Vektorsuche mit einer klassischen Stichwortsuche, zum Beispiel nach dem BM25-Verfahren, und führt beide Trefferlisten zusammen. Ein nachgeschaltetes Reranking-Modell bewertet die besten Treffer noch einmal im direkten Vergleich mit der Frage und sortiert sie neu. Erst die obersten Treffer gehen als Kontext an das Sprachmodell. Das verbessert die Trefferqualität und hält den Kontext kurz.
Zugriffsrechte pro Dokument
Ein RAG-System darf einem Nutzer nur Inhalte zeigen, die er auch in der Quelle sehen dürfte. Die Rechte müssen deshalb bei der Suche greifen, nicht erst im Prompt. Übernehmen Sie die Berechtigungen aus dem Quellsystem, etwa Gruppen aus dem Verzeichnisdienst, als Metadaten an jeden Chunk. Bei jeder Abfrage filtert die Suche dann nach den Gruppen des angemeldeten Nutzers. Eine Anweisung an das Sprachmodell, bestimmte Inhalte nicht zu nennen, ersetzt diesen Filter nicht. Prüfen Sie das Rechtekonzept gemeinsam mit Ihrem Datenschutzbeauftragten, wenn personenbezogene Daten im Bestand sind.
Index aktuell halten
Das System ist nur so aktuell wie sein Index. Eine Aktualisierungsstrecke erkennt neue, geänderte und gelöschte Dokumente in den Quellen, zerlegt und bettet nur die betroffenen Teile neu ein und entfernt gelöschte Inhalte aus dem Index. Auch geänderte Berechtigungen müssen übernommen werden. Je nach Quelle läuft das zeitgesteuert oder ereignisgesteuert, sobald ein Dokument gespeichert wird.
Sprachmodell anbinden
Für die Antwort selbst können Sie eine kommerzielle Schnittstelle oder ein offenes Modell im eigenen Betrieb nutzen. Bei kommerziellen Schnittstellen gehen Frage und Kontext an den Anbieter. Wenn Sie ein offenes Modell auf eigener Hardware oder bei einem Hoster in Deutschland betreiben, verlassen die Daten Ihre Infrastruktur nicht. Welche Wege es gibt, interne Daten mit ChatGPT oder Alternativen zu nutzen, beschreibt unser Ratgeber ChatGPT mit eigenen Daten füttern.
Antwortqualität messen
Ohne Messung lässt sich nicht beurteilen, ob eine Änderung am Chunking oder am Modell die Antworten verbessert. Legen Sie einen Testsatz mit typischen Fragen aus dem Fachbereich an, jeweils mit der erwarteten Antwort und den Dokumenten, die sie belegen. Bewerten Sie zwei Ebenen getrennt. Bei der Suche prüfen Sie, ob die richtigen Dokumente unter den ersten Treffern sind. Bei der Antwort prüfen Sie, ob sie sich auf den gefundenen Kontext stützt und die Frage beantwortet. Frameworks wie Ragas bieten dafür Kennzahlen wie Faithfulness, Answer Relevancy, Context Precision und Context Recall. Lassen Sie zusätzlich Stichproben durch Fachleute bewerten und wiederholen Sie den Test nach jeder Änderung.
Einordnung für IT-Verantwortliche
Starten Sie mit einem klar abgegrenzten Dokumentbestand und einer Nutzergruppe. So können Sie Chunking, Suche und Rechtefilter mit überschaubarem Aufwand testen, bevor weitere Quellen hinzukommen. Planen Sie die Aktualisierungsstrecke und die Rechteübernahme von Anfang an mit, denn beides lässt sich schlecht nachrüsten. Eine fokussierte MVP-Entwicklung mit begleitender Messung der Antwortqualität zeigt früh, ob die Architektur für den Fachbereich trägt.
Häufig gestellte Fragen (FAQ)
Ersetzt RAG das Fine-Tuning eines Modells?
Für die Nutzung interner Dokumente in vielen Fällen ja. RAG bindet eigene Inhalte ohne zusätzliches Training an. Fine-Tuning ist eher sinnvoll, wenn das Modell einen bestimmten Stil oder ein festes Ausgabeformat lernen soll.
Welche Vektordatenbank eignet sich für den Einstieg?
Wenn Sie bereits PostgreSQL betreiben, ist pgvector ein naheliegender Einstieg, weil Sie keine weitere Datenbank einführen müssen. Für große Bestände oder komplexe Filter kommen spezialisierte Systeme wie Qdrant in Frage. Beide lassen sich selbst betreiben.
Lässt sich eine RAG-Architektur vollständig im eigenen Betrieb umsetzen?
Ja. Embedding-Modell, Vektordatenbank und Sprachmodell können als offene Software auf eigenen Servern oder bei einem Hoster in Deutschland laufen. Dann verlassen Dokumente und Fragen Ihre Infrastruktur nicht.
Können Halluzinationen mit RAG ausgeschlossen werden?
Nein. RAG reduziert erfundene Aussagen, weil sich das Modell an den gefundenen Textstellen orientiert. Fehler bleiben möglich, etwa wenn die Suche unpassende Stellen liefert. Messen Sie die Antwortqualität regelmäßig und lassen Sie kritische Antworten fachlich prüfen.
Wie oft muss der Index aktualisiert werden?
Das hängt davon ab, wie oft sich die Quellen ändern. Für häufig geänderte Dokumente eignet sich eine ereignisgesteuerte Aktualisierung beim Speichern, für eher statische Bestände eine zeitgesteuerte. Geänderte Berechtigungen sollten immer zeitnah übernommen werden.