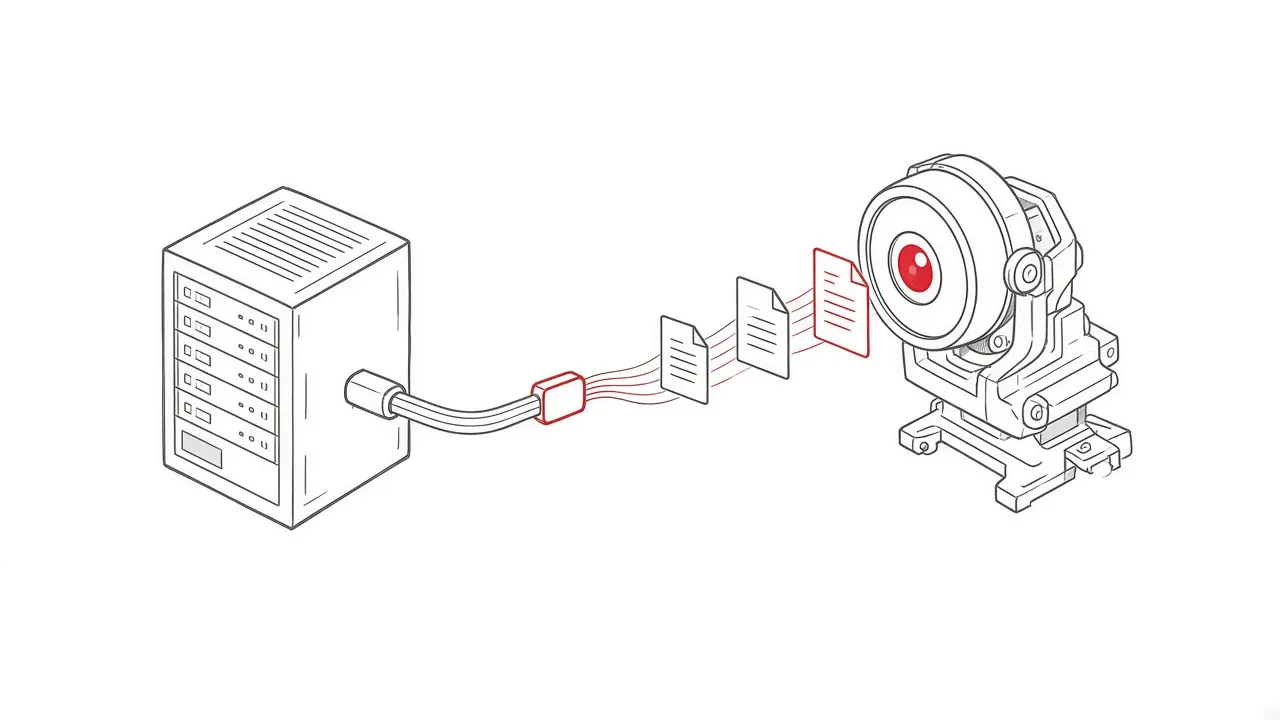
Wie oft sucht der Googlebot meine Seite auf? Frequenz und Steuerung
Wenn Sie neue Inhalte veröffentlichen oder technische Anpassungen an Ihrer Webpräsenz vornehmen, stellt sich schnell eine zentrale Frage: Wie oft sucht der Googlebot meine Seite auf, um diese Änderungen zu erfassen? Die Antwort darauf ist nicht statisch, sondern hängt von einer Vielzahl technischer und inhaltlicher Signale ab, die Ihre Server an die Suchmaschine senden.
Der Googlebot durchsucht das Internet kontinuierlich nach neuen Informationen, folgt Links und ruft Daten ab, um den Suchindex auf dem neuesten Stand zu halten. Für Betreiber einer Website ist es wichtig, diesen Prozess zu verstehen, da eine reibungslose Erfassung die technische Grundvoraussetzung für jede organische Sichtbarkeit darstellt.
Die Arbeitsweise des Googlebots verstehen
Hinter dem Begriff Googlebot verbergen sich primär zwei Arten von Web-Crawlern: der Googlebot für Smartphones und der Googlebot für Computer. Da die Google-Suche mittlerweile primär die mobile Version von Inhalten für die Indexierung heranzieht, erfolgt der Großteil der Abrufe über den mobilen Crawler. Beide simulieren das Verhalten eines regulären Nutzers mit dem entsprechenden Endgerät.
Beim Abruf gelten technische Grenzen, etwa für die Dateigröße pro Ressource. Welche Grenzen das sind und wie Sie die Besuche bei Serverüberlastung gezielt drosseln, erklärt unser Ratgeber zum Thema Googlebot-Frequenz einstellen.
Frequenz: Wie oft sucht der Googlebot eine Seite im Durchschnitt auf?
Es gibt kein festes Intervall für die Besuche des Crawlers. In der Praxis reicht die Zeitspanne von wenigen Minuten bei großen Nachrichtenportalen bis hin zu mehreren Wochen bei selten aktualisierten Unterseiten kleiner Websites. Wichtige und häufig verlinkte Seiten wie die Startseite ruft der Bot in der Regel deutlich öfter ab als tief verschachtelte Unterseiten. Die Dokumentation von Google Search Central nennt zudem eine Obergrenze für die Zugriffsrate: Bei den meisten Websites soll der Googlebot im Durchschnitt nicht häufiger als einmal alle paar Sekunden auf die Website zugreifen. Diese Angabe beschreibt die maximale Belastung Ihres Servers, nicht den Abstand, in dem eine einzelne Unterseite erneut gecrawlt wird.
Die genaue Häufigkeit wird durch das Zusammenspiel zweier Größen bestimmt, die Google intern für jede Domain berechnet.
- Das Crawl Rate Limit ist die Kapazitätsgrenze. Es beschreibt die maximale Anzahl gleichzeitiger Verbindungen und Abrufe, die Google durchführt, ohne Ihren Server zu überlasten. Reagiert Ihr Server schnell und stabil, erhöht sich dieses Limit. Treten gehäuft Timeouts oder 5xx-Fehler auf, drosselt die Suchmaschine die Frequenz deutlich.
- Der Crawl Demand ist der Crawling-Bedarf. Er beschreibt, wie wichtig oder aktuell Google Ihre Inhalte einschätzt. Hohe Popularität im Netz, eine starke Verlinkung und regelmäßige inhaltliche Aktualisierungen steigern den Bedarf.
Wie viele Abrufe Google tatsächlich durchführt, sehen Sie in der Search Console unter Einstellungen im Bericht „Crawling-Statistiken“. Er zeigt die Anzahl der Crawling-Anfragen pro Tag, die durchschnittliche Antwortzeit Ihres Servers und die Verteilung nach Statuscodes und Dateitypen. Ein plötzlicher Rückgang der Anfragen bei steigender Antwortzeit deutet auf ein Serverproblem hin, was häufig die erste Spur ist, wenn der Sichtbarkeitsindex plötzlich gefallen ist.
Wie lange es nach einem Besuch dauert, bis eine Änderung in den Suchergebnissen sichtbar wird, ist eine eigene Frage. Einen Zeitplan dazu finden Sie in unserem Ratgeber, wie lange Google braucht, um Änderungen zu erkennen.
Logfiles auswerten: Echte Googlebot-Besuche prüfen
In den Server-Statistiken tauchen oft unzählige Zugriffe auf, die vorgeben, von der Suchmaschine zu stammen. Da sich der sogenannte User-Agent, also die Kennung des zugreifenden Programms, problemlos fälschen lässt, tarnen sich viele Spam-Bots oder aggressive Scraper als Googlebot. Um die Serverkapazität zu schonen, ist es wichtig, legitime von schädlichen Zugriffen zu unterscheiden.
Um valide Googlebot-Besuche prüfen zu können, reicht ein Blick auf den User-Agent allein nicht aus. Die zuverlässigste Methode ist der umgekehrte DNS-Lookup (Reverse DNS). Dabei nehmen Sie die IP-Adresse aus Ihrem Server-Logfile und prüfen über ein Kommandozeilen-Tool, ob der zugehörige Hostname auf googlebot.com oder google.com endet. Ein anschließender Vorwärts-Lookup dieses Namens muss wiederum exakt die ursprüngliche IP-Adresse ergeben. Alternativ gleicht man die zugreifenden IPs automatisiert mit der von Google offiziell publizierten Liste der eigenen IP-Bereiche ab.
Effizienz steigern: Crawl-Budget optimieren für KMU
Das Crawl-Budget definiert die Menge an URLs, die Google auf einer Domain abruft. Für kleine Webvisitenkarten stellt dieses Budget selten einen Engpass dar. Doch sobald eine Seite durch Filterfunktionen, Parameter-URLs oder einen angeschlossenen Produktkatalog stark anwächst, werden die Ressourcen knapp.
Wenn Sie als KMU Ihr Crawl-Budget optimieren oder eine professionelle Suchmaschinenoptimierung für KMU umsetzen, sorgen Sie dafür, dass der Crawler seine begrenzte Zeit nicht mit irrelevanten oder technischen URLs verschwendet, sondern sich auf Ihre wichtigen Inhalte konzentriert. Setzen Sie dazu folgende Hebel an:
Unnötige URLs und Fehlerquellen reduzieren
Vermeiden Sie es, dem Bot endlose URL-Räume ohne Mehrwert anzubieten. Parameter, die lediglich Inhalte sortieren, sollten technisch konsolidiert werden. Ein zentraler Punkt ist die Vermeidung von Soft-404-Fehlern. Hierbei signalisiert der Server fälschlicherweise einen erfolgreichen Abruf (Statuscode 200), obwohl die Seite leer ist oder nicht mehr existiert. Solche URLs binden unnötig Ressourcen. Dauerhaft gelöschte Inhalte sollten mit einem sauberen 404- oder 410-Statuscode antworten, damit der Crawler sie aus der regelmäßigen Warteschlange entfernt.
Serverleistung und Caching verbessern
Je schneller Ihr Server antwortet, desto mehr Seiten kann der Bot im gleichen Zeitfenster abarbeiten. Eine lange Time to First Byte (TTFB) zwingt den Crawler zum Warten. Nutzen Sie zudem HTTP-Caching: Wenn der Server bei unveränderten Inhalten den Statuscode 304 (Not Modified) zurückgibt, weiß der Bot sofort, dass er die bereits bei ihm zwischengespeicherte Version nutzen kann. Das schont Bandbreite auf beiden Seiten und erhöht die Effizienz des Crawlings.
Architektur für ein reibungsloses Crawling
Der Crawler entdeckt neue Adressen hauptsächlich über interne und externe Links. Seiten, die keine eingehenden Links besitzen (sogenannte Orphan Pages) oder nur über ein internes Suchfeld erreichbar sind, bleiben für den Bot praktisch unsichtbar. Eine flache, logisch aufgebaute Hierarchie mit sauberen href-Attributen ist daher Pflicht.
Eine häufige Fehlerquelle sind aufwendige JavaScript-Konstrukte. Zwar verfügt Google über einen Web Rendering Service, der JavaScript ausführen kann. Dennoch sollten zentrale Texte und Links idealerweise direkt im initialen HTML-Quelltext vorhanden sein. Inhalte, die erst durch eine bewusste Nutzeraktion (wie Klicken oder komplexes Scrollen) in das Dokument geladen werden, bleiben dem Crawler oftmals verborgen, da dieser nicht wie ein menschlicher Besucher mit der Benutzeroberfläche interagiert.
Ob Sie bestimmte Bereiche gezielt für Crawler sperren oder aus dem Index ausschließen sollten, ist eine eigene Entscheidung. Den Unterschied zwischen einer Sperre in der robots.txt und einer noindex-Anweisung behandeln wir in unserem Ratgeber zu Sitemap und robots.txt.
Zusammenfassender Überblick zur Bot-Steuerung
Die Frequenz und Tiefe, mit der automatisierte Systeme Ihre Website erfassen, ist das direkte Resultat Ihrer technischen Infrastruktur. Schnelle Serverantwortzeiten, eine logische Verlinkungsstruktur ohne Sackgassen und der konsequente Einsatz korrekter Statuscodes bilden das Fundament. Indem Sie irrelevante URLs ausdünnen und die Erreichbarkeit kritischer Inhalte sicherstellen, steuern Sie die begrenzten Ressourcen zielgerichtet auf die Bereiche, die Ihre digitale Sichtbarkeit langfristig tragen sollen.
Häufige Fragen zur Arbeit der Suchmaschinen-Crawler
Die nachfolgenden Antworten fassen die wichtigsten Aspekte rund um das technische Auslesen von Webseiten kompakt zusammen.
Gibt es einen festen Rhythmus für die Bot-Besuche?
Nein, es gibt keine fest definierten Abstände. Die Häufigkeit wird dynamisch berechnet und richtet sich nach der Serverkapazität, der allgemeinen Beliebtheit der Domain sowie der Häufigkeit inhaltlicher Aktualisierungen. Das Intervall kann von wenigen Minuten bis hin zu mehreren Wochen variieren.
Wo sehe ich, wie oft der Googlebot meine Website besucht?
In der Google Search Console finden Sie unter Einstellungen den Bericht „Crawling-Statistiken“. Er zeigt die Crawling-Anfragen pro Tag, die durchschnittliche Antwortzeit Ihres Servers und die Verteilung nach Statuscodes. Für einzelne URLs zeigt die URL-Prüfung das Datum des letzten Crawls.
Wie unterscheidet sich Crawling von der Indexierung?
Crawling ist lediglich der technische Vorgang des Abrufens und Herunterladens von Dateien durch das automatisierte Programm. Die Indexierung ist ein nachgelagerter Prozess, bei dem die Suchmaschine die heruntergeladenen Informationen analysiert und entscheidet, ob diese für Suchanfragen relevant genug sind, um im Suchindex gespeichert zu werden.
Kann der Crawler JavaScript-Inhalte verarbeiten?
Ja, moderne Crawler nutzen Rendering-Dienste (oft basierend auf Chromium), um JavaScript auszuführen und die dynamisch erzeugten Seiteninhalte zu lesen. Allerdings erfordert dies mehr Ressourcen. Inhalte, die erst nach Nutzeraktionen wie Klicks nachgeladen werden, werden oft nicht erkannt.
Kann ich den Crawler manuell auf meine Seite rufen?
Ein direkter Startbefehl ist nicht möglich. Über spezielle Verwaltungstools der Suchmaschinenbetreiber lassen sich jedoch geänderte URLs zur Prüfung einreichen oder aktualisierte Sitemaps übermitteln, was den Besuch für diese spezifischen Bereiche in der Regel beschleunigt.
Sorgen regelmäßige Besuche für ein gutes Ranking?
Nein. Ein erfolgreicher Abruf stellt lediglich sicher, dass die Suchmaschine die Inhalte technisch lesen konnte. Für die spätere Positionierung in den Suchergebnissen bewerten nachgelagerte Algorithmen die Relevanz, inhaltliche Qualität und Autorität des Dokuments.